参考论文与本文目标
本文围绕 Lipman 等人的原始论文 Flow Matching for Generative Modeling 展开,重点讲解:
- 定理1:条件流如何合成为正确的边缘流;
- 定理2:为什么用条件速度做 MSE 训练,等价于学习边缘速度;
- 定理3:高斯条件路径对应的速度场如何得到;
- 最优条件传输路径:为什么它是直线、常速,以及它和“全局最优传输”到底是什么关系。
Flow Matching 解决了什么问题?
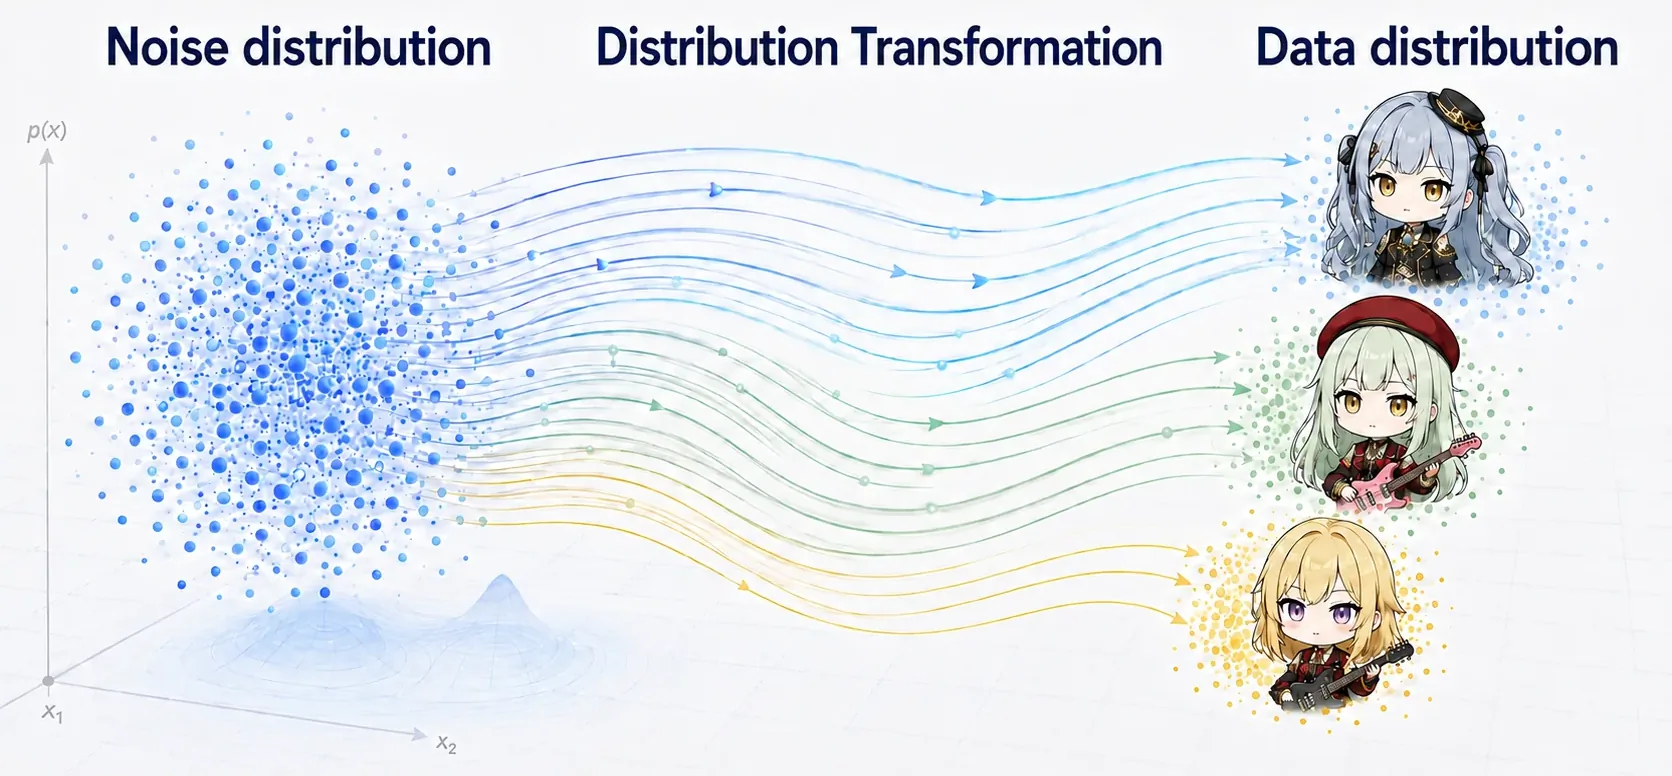
如图所示,我们可以将图像生成任务看成是构造一个从简单分布到目标数据分布的连续变换:
$$ \mathcal T: p_0 \longrightarrow p_1, \qquad p_1=\mathcal T_{\char"23}p_0, $$
更标准地说,$\mathcal T$ 映射的是样本空间中的点:
$$ \mathcal T:\mathbb R^d\to\mathbb R^d, \qquad p_1=\mathcal T_{\char"23}p_0, $$
其中 $\mathcal T_{\char"23}p_0$ 表示分布 $p_0$ 在映射 $\mathcal T$ 下的推前分布。
比如简单分布可以是一个协方差是对角矩阵的高斯分布:
$$ p_0 = \mathcal N(0,I), $$
而:
$$ p_1 \approx q_{\text{data}}. $$
这里用 $\mathcal T$ 表示从简单分布到目标数据分布的整体变换。我们从简单分布 $p_0$ 中采样得到噪声样本 $x_0\sim p_0$,目标图像样本记为 $x_1\sim p_1$。有了这个变换,就可以按照下面的表达式生成目标图像:
$$ \hat{x}_1=\mathcal T(x_0), \qquad \hat{x}_1\sim p_1. $$
其中 $\hat{x}_1$ 是模型生成的目标图像,$x_1$ 是数据分布中的真实目标图像样本。
而流匹配方法实现这个变换的原理是连续归一化流(Continuous Normalizing Flow, CNF)。其核心思想是找到一个随时间变化的向量场 $u_t(x)$,其中的粒子(样本)运动需要满足常微分方程 ODE:
$$ \frac{dx_t}{dt}=u_t(x_t). $$
然后从 $x_0\sim p_0$ 出发,从 $t=0$ 沿常微分方程积分到 $t=1$,最终可以得到:
$$ x_1\sim p_1. $$
但一般我们无法直接通过目标数据分布反推出 $u_t(x)$。而 Flow Matching 的核心技巧,是把复杂的整体速度场 $u_t(x)$ 拆成很多针对单个数据样本的条件速度场 $u_t(x | x_1)$ 来拟合。接下来我们将从流匹配论文中的三个定理来说明:
- 为什么复杂的整体速度场(或者也被命名为边缘速度场) $u_t(x)$ 可以由一系列针对单个目标样本的条件速度场 $u_t(x | x_1)$ 的期望来构造?
- 为什么通过一个容易计算的“条件流匹配”(Conditional Flow Matching, CFM)损失函数 $ \mathcal L_\text{CFM}$ 来训练模型,与使用原始的、但无法计算的流匹配损失函数 $\mathcal L_\text{FM}$ 是等效的?
- 如何选择一个具体的、在实践中表现良好的条件概率路径 $ p_t (x | x_1 )$ 和对应的向量场 $u_t (x|x_1 )$ ?
不过在此之前我们需要为定理分析预先引入一些概念。
概念引入
条件概率路径 Conditional Probability Path
从数据分布中抽取一个数据样本:
$$ x_1\sim q(x_1). $$
固定这个样本 $x_1$ 后,可以设计一个条件概率路径,这个概率路径可以用一个随时间变化的概率密度函数表示:
$$ p_t(x\mid x_1). $$
这个条件概率路径表示:如果我们选定终点样本 $x_1$,那么在中间时间 $t$,粒子的位置 $x$ 应该服从什么分布?例如对于初始的简单分布 $x_0 \sim \mathcal N(0,I)$ 和样本 $x_1$ 可以构建一个条件概率路径:
$$ x_t = (1-t)x_0 + tx_1 $$
我们可以看到随着 $t$ 从0增长到1,$x_t$ 逐渐从高斯噪声分布变为指定样本的分布。
上式对应 $\sigma_{\min}=0$ 的退化终点。原论文在实际构造中通常保留 $\sigma_{\min}>0$,此时条件路径的终点不是严格集中在 $x_1$ 上,而是:
$$ p_1(x\mid x_1) = \mathcal N(x\mid x_1,\sigma_{\min}^2I), $$
也就是以 $x_1$ 为中心、方差很小的高斯分布。
而当所有 $x_1$ 对应的条件路径 conditional paths 被混合起来就能得到边缘概率路径 Marginal Probability Path:
$$ p_t(x) = \int p_t(x\mid x_1)q(x_1)\thinspace dx_1. $$
概率密度与概率流量
$p_t(x)$ 描述了 $t$ 时刻位置 $x$ 的概率密度,而速度场 $u_t(x)$ 描述了在时间 $t$、位置 $x$,粒子应该朝哪个方向、以多快速度运动。
相应地我们可以用 $流量 = 密度 \times 速度$ 的思路定义概率流量 (probability flux / probability current):
$$ J_t(x)=p_t(x)u_t(x). $$
连续性方程:概率质量守恒
Flow Matching 使用的核心偏微分方程是:
$$ \frac{\partial p_t(x)}{\partial t} + \nabla\cdot \left( p_t(x)u_t(x) \right) =0. $$
也就是连续性方程(continuity equation)。
为了方便理解,我们可以先在一维情况下考虑:
$$ \frac{\partial p}{\partial t} + \frac{\partial}{\partial x}(pu) =0. $$
这样方程就可以被理解为:某个位置的概率密度之所以增加,是因为流入比流出多;某个位置的概率密度之所以减少,是因为流出比流入多。
这对于流匹配方法来说很重要,因为一个概率分布在速度场中移动时应当满足没有概率凭空产生、也没有概率凭空消失的要求,也就是概率密度函数的积分应该为1。也就是说在已经满足基本的光滑性、可积性以及 ODE 流存在唯一解(指对每个初始点 $x_0$,ODE 都有唯一轨迹)等条件下,连同初始条件 $p_{t=0}=p_0$,满足连续性方程应该是边缘速度场 $u_t(x)$ 能生成边缘概率路径的充分必要条件。
有了以上铺垫,我们就可以来理解流匹配方法的第一个定理了。
定理1:条件流 (Conditional Flow) 如何合成边缘流 (Marginal Flow)
定理说明和定理解决的问题
对于每个终点 $x_1$,我们假设已经有条件概率路径 $p_t(x\mid x_1)$ 以及相应的条件向量(速度)场 $u_t(x\mid x_1)$,那所有条件流混在一起之后,整体的(边缘)速度场应该是什么?
之前我们已经提到 $流量 = 密度 \times 速度$,那么:
对于某一小群终点位于 $x_1$ 的粒子,它们在 $x$ 处的概率密度是:
$$ p_t(x\mid x_1)q(x_1)\thinspace dx_1, $$
其中 $q(x_1)$ 表示数据分布在 $x_1$ 处的概率密度;如果使用有限训练集对应的经验分布,则它对应训练时抽取样本 $x_1$ 的概率。
根据条件速度场已知这一群粒子的速度是:
$$ u_t(x\mid x_1). $$
所以这一小群粒子在位置 $x$ 附近产生一个微小概率流:
$$ dJ_t(x) = p_t(x\mid x_1) u_t(x\mid x_1) q(x_1)\thinspace dx_1. $$
那么 $x$ 附近总的流量就是不同目的地 $x_1$ 对应的概率流叠加:
$$ J_t(x) = \int p_t(x\mid x_1) u_t(x\mid x_1) q(x_1)\thinspace dx_1. $$
另一方面 $x$ 附近总的流量又是该位置总的概率密度和边缘速度的乘积:
$$ J_t(x)=p_t(x)u_t(x), $$
于是:
$$ p_t(x)u_t(x) = \int p_t(x\mid x_1) u_t(x\mid x_1) q(x_1)\thinspace dx_1. $$
最终可得所有条件速度场混合得到的边缘速度场的形式:
$$ u_t(x) = \int u_t(x\mid x_1) \frac{ p_t(x\mid x_1)q(x_1) }{ p_t(x) } dx_1. $$
这个比值形式在 $p_t(x)>0$ 的位置上定义;在 $p_t(x)=0$ 的区域没有概率质量,速度场如何延拓不会影响概率路径的演化。
在这个式子中我们可以看到一个体现 Bayes 公式的部分:
$$ \frac{ p_t(x\mid x_1)q(x_1) }{ p_t(x) } = p_t(x_1\mid x), $$
所以根据 Bayes 公式,实际上整体(边缘)速度场是所有可能条件速度场在“已知当前位置 $x$”或者说固定当前位置 $X_t=x$ 条件下的后验加权平均:
$$ u_t(x) = \mathbb E[ u_t(x\mid X_1)\mid X_t=x ]. $$
从这里也能看出来虽然同一个位置 $x$ 可能对应多个终点 $x_1$,但边缘速度场不取决于特定样本对应的条件概率路径,也就是说不需要知道某个粒子“原本计划去哪个 $x_1$”,而是对所有可能终点做后验加权平均。因此条件概率路径是训练辅助构造,不是最终生成轨迹必须逐条复现的对象。
而定理1的证明部分则需要证明这个形式的边缘速度场满足连续性方程(能够生成边缘概率路径的充要条件)。
定理1的证明
已知:
$$ p_t(x) = \int p_t(x\mid x_1)q(x_1)\thinspace dx_1. $$ 对 $t$ 求导:
$$ \frac{\partial p_t(x)}{\partial t} = \int \frac{\partial p_t(x\mid x_1)}{\partial t} q(x_1)\thinspace dx_1. $$
由于每个条件概率路径都由 $u_t(x\mid x_1)$ 生成,因此满足连续性方程:
$$ \frac{\partial p_t(x\mid x_1)}{\partial t} = - \nabla\cdot \left[ p_t(x\mid x_1) u_t(x\mid x_1) \right]. $$
代入:
$$ \frac{\partial p_t(x)}{\partial t} = - \int \nabla\cdot \left[ p_t(x\mid x_1) u_t(x\mid x_1) \right] q(x_1)\thinspace dx_1. $$
交换积分与散度:
$$ = - \nabla\cdot \left[ \int p_t(x\mid x_1) u_t(x\mid x_1) q(x_1)\thinspace dx_1 \right]. $$
利用:
$$ p_t(x)u_t(x) = \int p_t(x\mid x_1) u_t(x\mid x_1) q(x_1)\thinspace dx_1, $$
代换中括号中的式子得到:
$$ \frac{\partial p_t(x)}{\partial t} = - \nabla\cdot [p_t(x)u_t(x)]. $$
即:
$$ \frac{\partial p_t(x)}{\partial t} + \nabla\cdot [p_t(x)u_t(x)] =0. $$
所以论文给出的 $u_t(x)$ 形式满足连续性方程,能够生成对应的边缘概率路径。
定理2:为什么用条件流匹配可以训练神经网络拟合边缘速度场?
定理说明和定理解决的问题
定理1给出了正确的边缘速度场形式 $u_t(x)$ 。但实际训练时,它通常仍然难以计算,因为:
$$ u_t(x) = \int u_t(x\mid x_1)p_t(x_1\mid x)\thinspace dx_1 $$
需要对大量样本 $x_1$ 积分。
定理2则给出了一种不需要计算出一个个具体位置的 $u_t(x)$ 速度值作为训练目标就可以产生监督信号让神经网络 $v_\theta(t,x)$ 拟合出速度场 $u_t(x)$ 。而这个方法就是用容易根据每个具体样本计算的条件流匹配损失 (Conditional Flow Matching loss) :
$$ \mathcal L_{\rm CFM} = \mathbb E_{ t,\thinspace x_1\sim q,\thinspace x\sim p_t(x\mid x_1) } \left[ \lVert v_\theta(t,x)-u_t(x\mid x_1)\rVert ^2 \right] $$
来替代理论上应该使用的流匹配损失 (Flow Matching loss) :
$$ \mathcal L_{\rm FM} = \mathbb E_{t,x\sim p_t} \left[ \lVert v_\theta(t,x)-u_t(x)\rVert ^2 \right] $$
因为根据定理2:
$$ \mathcal L_{\rm CFM} = \mathcal L_{\rm FM}+\text{constant}, $$
其中 $\text{constant}$ 与模型参数 $\theta$ 无关。因此:
$$ \nabla_\theta\mathcal L_{\rm CFM} = \nabla_\theta\mathcal L_{\rm FM}. $$
定理2的证明
固定 $t$ 后,暂时省略时间下标。下文用 $L_{\rm FM}$ 和 $L_{\rm CFM}$ 表示固定时刻的损失,用 $\mathcal L_{\rm FM}$ 和 $\mathcal L_{\rm CFM}$ 表示还对时间 $t$ 取期望的完整训练目标。
流匹配的损失函数:
$$ L_{\rm FM} = \int p(x) \lVert v(x)-u(x)\rVert ^2dx. $$
展开得到:
$$ L_{\rm FM} = \int p(x)\lVert v(x)\rVert ^2dx - 2\int p(x)v(x)^\top u(x)dx + \int p(x)\lVert u(x)\rVert ^2dx. $$
而条件流匹配的损失函数:
$$ L_{\rm CFM} = \int q(x_1) \int p(x\mid x_1) \lVert v(x)-u(x\mid x_1)\rVert ^2 dx\thinspace dx_1. $$
展开得到:
$$ L_{\rm CFM} = A-2B+C, $$
其中:
$$ A = \int q(x_1) \int p(x\mid x_1)\lVert v(x)\rVert ^2dx\thinspace dx_1, $$ $$ B = \int q(x_1) \int p(x\mid x_1) v(x)^\top u(x\mid x_1) dx\thinspace dx_1, $$ $$ C = \int q(x_1) \int p(x\mid x_1) \lVert u(x\mid x_1)\rVert ^2 dx\thinspace dx_1. $$
第一项利用:
$$ p(x)=\int p(x\mid x_1)q(x_1)\thinspace dx_1, $$
可得:
$$ A = \int p(x)\lVert v(x)\rVert ^2dx. $$
第二项利用:
$$ p(x)u(x) = \int p(x\mid x_1) u(x\mid x_1) q(x_1)\thinspace dx_1, $$
可得:
$$ B = \int p(x)v(x)^\top u(x)\thinspace dx. $$
第三项一般与流匹配中的:
$$ \int p(x)\lVert u(x)\rVert ^2dx $$
不同,但它们都与模型参数 $\theta$ 无关。
于是:
$$ L_{\rm CFM}=L_{\rm FM}+\text{constant}. $$
从“条件期望回归”的角度理解定理 2
条件流匹配损失可以替代流匹配损失,不仅可以从两者关于模型参数具有相同梯度的角度理解,还可以直接从 MSE 回归本身的性质理解。
为了方便理解同样固定时刻 $t$。
令条件流匹配损失的目标变量为:
$$ Y=u_t(X_t\mid X_1). $$
神经网络的输入为当前状态 $X = X_t$ 并前向传播得到预测值 $v(X)$
训练的目标是通过 MSE 找到最优预测器:
$$ v^* = \arg\min_v \mathbb E \left[ \left\lVert v(X)-Y \right\rVert ^2 \right]. $$
根据 MSE 回归的经典结论:在 MSE 损失下,最优预测器等于目标变量在给定输入条件下的条件期望。
因此,在输入取值为 $X_t=x$ 时:
$$ v^*(x) = \mathbb E \left[ Y\mid X_t=x \right]. $$
代入 $Y=u_t(X_t\mid X_1)$,得到:
$$ v^*(x) = \mathbb E \left[ u_t(X_t\mid X_1) \mid X_t=x \right]. $$
由于条件 $X_t=x$ 已经固定了当前位置,因此可写为:
$$ v^*(x) = \mathbb E \left[ u_t(x\mid X_1) \mid X_t=x \right]. $$
该期望是对条件分布下的 $X_1$ 求平均,所以也可以写作:
$$ v^*(x) = \mathbb E_{X_1\mid X_t=x} \left[ u_t(x\mid X_1) \right]. $$
这里的期望可以直观理解为:在固定时刻 $t$ 下,给定当前位置 $x$,对所有可能经过该位置、但具有不同终点 $X_1$ 的条件速度取平均。
而定理 1 告诉我们:
$$ \mathbb E \left[ u_t(x\mid X_1) \mid X_t=x \right] = u_t(x). $$
因此:
$$ v^*(x)=u_t(x). $$
也就是说,虽然条件流匹配训练时使用的是条件速度 $u_t(x\mid X_1)$ 作为监督信号,但 MSE 回归的最优解会自动对给定当前位置 $x$ 下不同的 $X_1$ 取条件平均,因此最终会得到所需的边缘速度场 $u_t(x)$。
从这个角度来看, 在固定时刻 $t$ 下,条件速度是监督信号,而边缘速度是这些监督信号在给定当前位置 $x$ 后的条件期望;而 MSE 回归恰好自动完成了这一条件平均。
实际训练时还需要在整个时间区间上对 $t$ 进行采样,因此完整的条件流匹配训练目标可以写成:
$$ v^* = \arg\min_v \mathbb E_{t,X_1,X_t} \left[ \left\lVert v_t(X_t) - u_t(X_t\mid X_1) \right\rVert ^2 \right]. $$
因此,可以把前面的分析理解为:对每一个固定的 $t$,MSE 回归都会得到对应的边缘速度场 $u_t(x)$;再对所有 $t$ 求期望,就得到完整的训练目标和对应的最优预测器 $v^*_\theta(t,x)$ 。
如何理解条件流匹配损失和流匹配损失之间与神经网络参数无关的常数项
对任意随机变量 $Y$,我们可以恒等地写:
$$ Y = \mathbb E[Y\mid X] + \left( Y-\mathbb E[Y\mid X] \right). $$
定义剩余误差:
$$ \epsilon = Y-\mathbb E[Y\mid X]. $$ 那么随机变量 $Y$ 就可以被看作是 (1) 只知道 $X$ 时对 $Y$ 能做出的平均预测 $\mathbb E[Y\mid X]$ 和 (2) 剩余误差 $ \epsilon$ 的和:
$$ Y=\mathbb E[Y\mid X]+\epsilon. $$
而剩余误差满足:
$$ \mathbb E[\epsilon\mid X]=0. $$
也就是说剩余误差 $ \epsilon$ 不再含有任何可以通过 $X$ 系统性预测出来的平均偏差。这是因为:
$$ \mathbb E[\epsilon\mid X] =\mathbb E\left[Y-\mathbb E[Y\mid X]\mid X\right] \qquad =\mathbb E[Y\mid X] -\mathbb E\left[\mathbb E[Y\mid X]\mid X\right]. $$
由于在固定 $X$ 以后期望 $\mathbb E[Y\mid X]$ 就已经是确定值。于是
$$ \mathbb E\left[\mathbb E[Y\mid X]\mid X\right] = \mathbb E[Y\mid X]. $$
因此
$$ \mathbb E[\epsilon\mid X] = \mathbb E[Y\mid X]-\mathbb E[Y\mid X] =0. $$
那么回到 MSE 损失对任意预测器 $f(X)$ 的训练,根据本节开头的恒等式:
$$ Y-f(X) = \left( \mathbb E[Y\mid X]-f(X) \right) + \epsilon. $$
可以证明两部分正交(证明在下一小节),即:
$$ \mathbb E\left[(\mathbb E[Y\mid X]-f(X))^\top\epsilon\right] = 0. $$
因此:
$$ \mathbb E\lVert Y-f(X)\rVert ^2 = \mathbb E[ \lVert \mathbb E[Y\mid X]-f(X)\rVert ^2 ] + \mathbb E\lVert \epsilon\rVert ^2. $$
第二项:
$$ \mathbb E\lVert \epsilon\rVert ^2 $$ 与 $f$ 无关,因此最优预测必然是:
$$ \boxed{ f^*(X)=\mathbb E[Y\mid X]. } $$ 回到 Flow Matching:
$$ Y=u_{\rm cond}, $$ $$ \mathbb E[Y\mid X]=u_{\rm marginal}. $$ 所以:
$$ L_{\rm CFM} = L_{\rm FM} + \mathbb E\lVert u_{\rm cond}-u_{\rm marginal}\rVert ^2. $$
之前证明中出现的常数可以理解为条件速度围绕边缘速度的方差。
随机变量的正交分解
把随机变量看成一种无限维向量,并定义内积:
$$ \langle A,B\rangle = \mathbb E[A^\top B]. $$
如果:
$$ \mathbb E[A^\top B]=0, $$
就可以说两个随机变量“正交”。
上一节的推导环节中有一个没有证明的定理—— $\mathbb E[Y\mid X]-f(X)$ 和 $\epsilon$ 正交。因为 $\mathbb E[Y\mid X]$ 和 $f(X)$ 都是关于 $X$ 的函数,二者的差值也是关于 $X$ 的函数,所以 $\mathbb E[Y\mid X]-f(X)$ 和 $\epsilon$ 正交作为下面这个更一般的定理的特例而成立:
$\epsilon$ 和任意只依赖于 $X$ 的函数 $g(X)$ 正交,也就是:
$$ \mathbb E[g(X)^\top\epsilon]=0. $$
下面给出证明。首先利用全期望公式:
$$ \mathbb E[g(X)^\top\epsilon] = \mathbb E\left[ \mathbb E[g(X)^\top\epsilon\mid X] \right]. $$
由于 $g(X)$ 是 $X$ 的函数,在给定 $X$ 后它是确定的,可以从条件期望中提出。同时之前已经证明
$$ \mathbb E[\epsilon\mid X] = 0, $$
所以:
$$ \mathbb E[g(X)^\top\epsilon] = \mathbb E\left[ g(X)^\top\mathbb E[\epsilon\mid X] \right] \qquad = \mathbb E[g(X)^\top 0] \qquad =0. $$
即对于任意只依赖于 $X$ 的函数 $g(X)$ 有
$$ g(X)\perp\epsilon. $$
更准确地说,如果记所有由 $X$ 构成的平方可积函数空间为
$$ \mathcal H_X = \lbrace g(X):g(X)\in\mathbb R^d,\ \mathbb E\lVert g(X)\rVert ^2<\infty\rbrace , $$
那么
$$ \epsilon\perp\mathcal H_X. $$
因此对于随机变量 $Y$ 有正交分解
$$ Y = \mathbb E[Y\mid X]+\epsilon $$
可以理解为:$\mathbb E[Y\mid X]$ 是 $Y$ 在 $\mathcal H_X$ 上的正交投影,而 $\epsilon$ 是与整个 $\mathcal H_X$ 正交的剩余部分。
                 Y
                /|
               / |
              /  | ε
             /   |
            /    |
           ●-----●
          0    E[Y|X]
       _____________
             H_X
定理3:高斯条件路径的速度场
定理说明
前两个定理告诉我们:
- 条件流可以合成正确的边缘流;
- 条件速度可以直接作为训练目标,也就是用条件流匹配替代流匹配计算MSE损失。
现在剩下的问题是$u_t(x\mid x_1)$如何构造?
原论文提出了高斯条件路径:
$$ p_t(x\mid x_1) = \mathcal N \left( x\mid \mu_t(x_1), \sigma_t(x_1)^2I \right). $$
记号 $\mathcal N(x\mid\mu,\Sigma)$ 表示:在位置 $x$ 处计算均值为 $\mu$、协方差为 $\Sigma$ 的高斯概率密度。 同时论文选择了以下流映射 flow map:
$$ \psi_t(x_0) = \sigma_t(x_1)x_0+\mu_t(x_1). $$
其中:
$$ x_0\sim\mathcal N(0,I). $$
高斯随机变量经过仿射变换后仍是高斯分布:
$$ X_t = \sigma_tX_0+\mu_t \sim \mathcal N(\mu_t,\sigma_t^2I). $$
根据以上条件有唯一对应的速度场:
$$ u_t(x\mid x_1) = \frac{\sigma_t’(x_1)} {\sigma_t(x_1)} \left( x-\mu_t(x_1) \right) + \mu_t’(x_1). $$
**注意:**给定概率路径 $p_t(x)$ 时,生成它的速度场一般不唯一。因为 $p_t(x)$ 只反映了概率分布的变化,不规定具体每个粒子如何运动。
但是一旦指定完整流映射 flow map:
$$ x_t=\psi_t(x_0), $$
也就意味着每一颗粒子的轨迹都确定,那么对应的速度场:
$$ u_t(x) = \dot\psi_t(\psi_t^{-1}(x)) $$
就是唯一的。
所以定理3中速度场的唯一性,是相对于给定的 $\psi_t$ 而言,而不是说高斯概率路径本身只能对应一个速度场。
定理3的推导(根据高斯条件路径推导相应的速度场)
已知在高斯条件路径中粒子轨迹是:
$$ x_t = \sigma_t x_0+\mu_t. $$
对 $t$ 求导:
$$ \frac{dx_t}{dt} = \sigma_t’x_0+\mu_t’. $$
但速度场应该写成当前位置 $x_t$ 的函数,而不是初始位置 $x_0$ 的函数,所以需要代换该变量。由:
$$ x_t-\mu_t = \sigma_t x_0, $$
得到:
$$ x_0 = \frac{x_t-\mu_t}{\sigma_t}. $$
代回:
$$ \frac{dx_t}{dt} = \frac{\sigma_t’}{\sigma_t} (x_t-\mu_t) +\mu_t’. $$
最后得到速度场的函数:
$$ u_t(x\mid x_1) = \frac{\sigma_t’(x_1)} {\sigma_t(x_1)} \left( x-\mu_t(x_1) \right) + \mu_t’(x_1). $$
定理3的物理解释
我们上一节给出的速度场函数可以分成两个部分:
$$ u_t(x\mid x_1) = \underbrace{ \frac{\sigma_t’}{\sigma_t}(x-\mu_t) }{\text{收缩/膨胀}} + \underbrace{ \mu_t' }{\text{整体平移}}. $$ 第一项 $\frac{\sigma_t’}{\sigma_t}(x-\mu_t)$ 描述当前高斯分布相对于中心的收缩或膨胀,当 $\sigma_t’<0$ 时整个高斯分布向中心收缩。第二项 $\mu_t’$ 表示高斯分布中心的移动速度。
最优条件传输路径 Optimal Transport Conditional Path
构建最优条件传输
虽然前面给出了高斯条件路径的速度场的形式,不过其中随时间变化的函数 $\mu_t$ 和 $ \sigma_t $ 还没确定。对于 $t \in [0,1]$,原论文中的最优传输条件路径选择:
$$ \mu_t(x_1)=t x_1, $$ $$ \sigma_t(x_1) = 1-(1-\sigma_{\min})t. $$ 为了简化记号,定义:
$$ a=1-\sigma_{\min}. $$
其中选择 $\sigma_{\min}>0$ 可以保证整个时间区间内 $\sigma_t>0$,从而保持仿射流映射可逆,并避免速度场公式在 $t=1$ 处出现零分母;它表示条件分布最后收缩到 $x_1$ 周围很小的区域。
根据以上条件:
$$ \sigma_t=1-at, \qquad \sigma_t’=-a, $$ $$ \mu_t=t x_1, \qquad \mu_t’=x_1. $$ 代入定理3:
$$ u_t(x\mid x_1) = -\frac{a}{1-at}(x-tx_1)+x_1 \qquad = \frac{x_1-ax}{1-at}. $$
回代 $a$:
$$ u_t(x\mid x_1) = \frac{ x_1-(1-\sigma_{\min})x }{ 1-(1-\sigma_{\min})t }. $$
这个构造之所以被称为最优传输条件路径,不只是因为轨迹是直线、常速,还因为它来自两个条件端点高斯分布之间的二次代价最优传输。对于固定的 $x_1$,条件路径的两个端点为:
$$ p_0(x\mid x_1)=\mathcal N(0,I), \qquad p_1(x\mid x_1)=\mathcal N(x_1,\sigma_{\min}^2I). $$
它们之间的最优传输映射为:
$$ T_{x_1}(x_0)=x_1+\sigma_{\min}x_0. $$
这个映射将 $X_0\sim\mathcal N(0,I)$ 变换为 $T_{x_1}(X_0)\sim\mathcal N(x_1,\sigma_{\min}^2I)$。相应的 Wasserstein-2 位移插值为:
$$ x_t =(1-t)x_0+tT_{x_1}(x_0) \qquad =[1-(1-\sigma_{\min})t]x_0+t x_1, $$
这正是上面选择的高斯条件路径。因此直线、常速是该最优传输位移插值的结果。
下面也可以直接从流映射看出它的直线匀速性质:
$$ x_t = \sigma_t x_0+\mu_t. $$ 代入最优传输条件路径:
$$ x_t = [1-(1-\sigma_{\min})t]x_0+t x_1 \qquad = x_0 + t \left[ x_1-(1-\sigma_{\min})x_0 \right]. $$
也就是:
$$ x_t=x_0+t\thinspace v, $$
对应的运动速度是与不依赖时间 $t$ 的常数:
$$ v= x_1-(1-\sigma_{\min})x_0. $$
所以每条粒子的轨迹都是直线匀速的。
流匹配的完整训练过程
根据定理3给出的最优传输条件路径可以最终给出完整的流匹配训练过程。为了方便说明,我们令 $\sigma_{\min}=0$。此时 $t=1$ 处的条件分布退化为集中在 $x_1$ 上的点质量,仿射流映射也不再可逆,因此定理3中含有 $\sigma_t^{-1}$ 的速度场公式严格地适用于 $t\in[0,1)$,或者可理解为 $\sigma_{\min}\to0^+$ 的极限。不过可以直接从路径表达式得到常速度目标:
$$ x_t=(1-t)x_0+t x_1 \qquad u_{\rm cond}=x_1-x_0. $$
一次训练的过程可以表示为:
- 采噪声:
$$ x_0\sim\mathcal N(0,I); $$ 2. 采数据:
$$ x_1\sim q; $$ 3. 采时间:
$$ t\sim U(0,1); $$ 4. 构造中间点:
$$ x_t=(1-t)x_0+t x_1; $$ 5. 构建条件流匹配目标:
$$ u_{\rm target}=x_1-x_0; $$ 6. 损失计算和反向传播:
$$ \boxed{ \lVert v_\theta(t,x_t)-(x_1-x_0)\rVert ^2. } $$
虽然作为理论依据的定理需要很多说明,但最终的训练流程却很简单。
关于最优条件传输路径的讨论
最优条件传输路径并不等于最优全局传输路径
一个需要注意的问题是论文给出的最优条件传输路径不等于最优全局传输路径。可以这样想象:在两个分布的转化过程中,首先要确定两个分布中各个粒子的对应关系,然后再根据粒子对应关系设计空间中两点的一条轨迹或者路径。最优传输条件路径是建立在随机选择的粒子匹配关系基础上的:虽然设计了两点间的直线路径,但是匹配关系不一定最优;有可能选择了两个间隔很远的粒子进行匹配,导致总的变换成本高于就近匹配的另一方案。
原论文中的训练通常分别采样:
$$ x_0\sim p_0, $$ $$ x_1\sim q. $$ 因此匹配关系通常来自乘积耦合(product coupling),即对起点和终点进行相互独立的采样:
$$ \pi(x_0,x_1) = p_0(x_0)q(x_1). $$
也就是说一个随机采样的噪声和一个随机选中的目标数据被配成一对。在这种情况下对匹配 $(x_0,x_1)$使用直线的条件路径可以保证 每一条件路径很简单,但并不意味着分布间的 $p_0 \rightarrow q$ 匹配最优。
而网络真正拟合的:
$$ u_t(x) = \mathbb E[u_{\rm cond}\mid X_t=x], $$
一般不等于任意一条条件轨迹。在最优条件传输的情况下,同一位置仍可能对应不同起点和终点的多条路径。
也就是说可能有不同的匹配 $(x_0^{(A)},x_1^{(A)})$ 和 $(x_0^{(B)},x_1^{(B)})$ 在同一个(t,x)附近经过。 它们各自的速度分别是:
$$ x_1^{(A)}-x_0^{(A)}, $$
和:
$$ x_1^{(B)}-x_0^{(B)}. $$
而网络仍然只输出一个边缘速度:
$$ v_\theta(t,x). $$
根据定理2可知这个位置的边缘速度是:
$$ v^*(t,x) = \mathbb E[ X_1-X_0 \mid X_t=x ]. $$
于是最简流匹配的核心公式可以写成:
$$ X_t=(1-t)X_0+tX_1, \qquad u_t(x) = \mathbb E[ X_1-X_0 \mid X_t=x ]. $$
最优条件传输路径的好处
最后额外说明一下为什么“直线”通常有利于采样。在用神经网络生成样本时需要在速度场上按路径做数值积分:
$$ \frac{dx}{dt}=v_\theta(t,x). $$
如果轨迹高度弯曲,那么往往需要更多小步长来准确追踪;相反,如果轨迹接近直线则可以使用更大的步长。 因此更直、更低曲率的流通常意味着更少的神经网络前向传播次数。
同时需要注意:
最优条件传输轨迹是直线,并不意味着最终学到的边缘轨迹一定完全直;它只提供了一种更简单的训练目标结构。流匹配真正关心的是概率分布的正确演化,而不是要求每一条训练时构造的条件轨迹都在最终生成模型里被逐条复现。
总结
为了训练一个从简单噪声分布到目标分布的流,流匹配方法并不是先求出一个复杂的全局速度场作为拟合目标训练网络。
可以把流匹配理论的思路总结为:
对单个数据样本 $x_1$ 构造容易处理的条件概率路径
通过定理3找到对应的条件速度场:
$$ p_t(x\mid x_1) \rightarrow u_t(x\mid x_1) $$
- 通过定理1保证可以通过条件速度场混合出正确的边缘速度场:
$$ u_t(x\mid x_1) \rightarrow u_t(x) $$
- 通过定理2保证无需显式计算 $u_t(x)$ 就可以用 $u_t(x\mid x_1)$ 作为 MSE 回归目标监督神经网络 $v_\theta(t,x_t)$ 训练,因为 MSE 回归本质是对条件速度做条件期望,而边缘速度正是给定 $X_t=x$ 后条件速度的条件期望。
论文中的核心公式:
- 边缘概率路径
$$ p_t(x) = \int p_t(x\mid x_1)q(x_1)\thinspace dx_1. $$
- 边缘概率流
$$ p_t(x)u_t(x) = \int p_t(x\mid x_1) u_t(x\mid x_1) q(x_1)\thinspace dx_1. $$
- 边缘速度 = 给定当前位置后条件速度的条件期望
$$ u_t(x) = \mathbb E[ u_t(x\mid X_1)\mid X_t=x ]. $$
- CFM 与 FM 的关系
$$ \mathcal L_{\rm CFM} = \mathcal L_{\rm FM} + C. $$
- 最优条件传输
$$ X_t=(1-t)X_0+tX_1, $$
$$ u_{\rm cond}=X_1-X_0. $$
参考资料
- Lipman, Y., Chen, R. T. Q., Ben-Hamu, H., Nickel, M., Le, M. Flow Matching for Generative Modeling. ICLR 2023. https://arxiv.org/abs/2210.02747
附录:我在学习流匹配中遇到的一些小问题
A.1 为什么当前位置接近某个终点时,边缘速度会更接近对应条件速度?
边缘速度场可以写成条件速度场关于后验分布的条件期望:
$$ u_t(x) = \mathbb E[ u_t(x\mid X_1)\mid X_t=x ] = \int u_t(x\mid x_1)\thinspace p_t(x_1\mid x)\thinspace dx_1. $$
其中后验权重满足 Bayes 公式:
$$ p_t(x_1\mid x) = \frac{ p_t(x\mid x_1)q(x_1) }{ p_t(x) }. $$
因此,如果对于某个终点 $x_1^$,当前位置 $x$ 使得后验分布高度集中于 $x_1^$:
$$ p_t(x_1\mid x) \approx \delta(x_1-x_1^*), $$
那么
$$ u_t(x) = \int u_t(x\mid x_1)p_t(x_1\mid x)\thinspace dx_1 \approx u_t(x\mid x_1^*). $$
因此,边缘速度接近某个条件速度的根本原因不是 $x$ 在几何上“接近”某个终点,而是
$$ p_t(x_1\mid x) $$
在该终点附近高度集中。换言之,真正决定各条件速度贡献权重的是后验分布 $p_t(x_1\mid x)$。
接下来是一个例子,假设:
$$ X_1=-10,\qquad X_1=+10, $$ 先验概率各为 $1/2$。
如果在某个时间 $t$ 观察到:
$$ X_t=9.8, $$ 并且此时:
$$ p_t(9.8\mid +10) \gg p_t(9.8\mid -10), $$ 那么:
$$ P(X_1=+10\mid X_t=9.8) \approx1. $$ 因此:
$$ u_t(9.8) = \mathbb E[ u_t(9.8\mid X_1)\mid X_t=9.8 ] $$ 会非常接近:
$$ u_t(9.8\mid+10). $$ 需要注意:仅仅知道 $x=9.8$ 并不能在任意 conditional path 下自动推出这一结论;真正决定权重的是:
$$ p_t(x_1\mid x). $$
A.2 条件速度都非零,边缘速度为什么可以为零?
假设:
$$ u_t(0\mid -10)=-3, $$
$$ u_t(0\mid +10)=+3, $$ 且当前位置 $x=0$ 时两个终点后验概率相同:
$$ P(X_1=-10\mid X_t=0) = P(X_1=+10\mid X_t=0) = \frac12. $$ 那么:
$$ u_t(0) = \frac12(-3)+\frac12(+3) =0. $$ 这并不意味着所有粒子都静止,它只意味着当前位置的净概率流为零。
A.3 条件路径不等于最终生成路径
训练时 $(x_0,x_1)$ 之间构造的条件轨迹是产生监督信号的工具。
最终生成时只解:
$$ \frac{dx}{dt}=v_\theta(t,x), $$ 模型通常并不知道预先指定的 $x_1$。所以最终轨迹不会逐条复现训练时的条件轨迹。